AI落地经验与技巧
实际AI解决问题和思想
vibe coding
思想主要是快速调整,快速落地,不用去追求文档完美 ====> 业务第一、UI第二、代码第三
需求方面
需求

1.和AI聊天按照自己思路走 (落地大概需求,进行细致需求拆分)

2.沟通一段,别频繁更新,应该多沟通然后进行更改,自己审查决定文件的落地

3.之后进行全局文档规则审查(文档是不是有冲突)

4.技术落地到需求文档里面,遵循组件化、模块化、别重复造轮子,用开源项目轮子、可插拔

5.遇到问题,直接问AI实现这个功能的逻辑是什么,然后去判定他的逻辑然后去改进

6.可以找类似的开源项目,让gpt去读他的代码,找到适合我们学习使用的方案架构,确认使用什么第三方,第三方的可行性 (学习一下优秀的开源架构)

7.需求收尾:Onebyone 把没搞定的一个一个提出 我回答,参照我们其他的设定,把你能确定的直接按照规范确定,能根据架构自主决定的都处理了
AI更新的内容你要进行掌握,别让他直接改,提前沟通看看他要改什么
我看看你打算怎么样修改
修改之后的内容是什么
架构
组件化:这件事由谁负责? 接口化:别人怎么使用它? 可插拔:以后怎么把它换掉?
① 组件化:做成一块独立的键盘。

按键、线路、输入处理都装在键盘里。键盘专门负责输入,屏幕专门负责显示。

重点是:把职责分开,各管各的。


② 接口化:规定键盘怎么连接电脑。

例如使用 USB,并遵守对应的通信标准。电脑不用了解键盘内部线路,就能接收输入。

重点是:规定双方怎么配合。


③ 依赖倒置:电脑依赖“键盘标准”,而不是依赖某一把具体键盘。

电脑只认统一的键盘接口和输入规则,不需要知道接入的是罗技、Cherry 还是其他品牌;具体键盘反过来遵守这个标准来接入电脑。

重点是:核心依赖标准,不依赖具体实现。


业务规则不直接依赖数据库、供应商等具体实现;业务与具体实现都围绕抽象契约工作,抽象契约不泄露底层技术细节。


④ 可插拔:可以换另一把兼容键盘。

旧键盘拔掉,新键盘接上,只要新键盘遵守同样的接口标准,电脑仍然可以按原来的方式使用,不需要为这把新键盘重新改造电脑。

重点是:可以替换,其他部分尽量不受影响。
UI
UI组件话,比如 常用的按,都做成组件复用

抛弃当前的设计,你根据我们的文档重新设计UI效果图


需要现代化UI的设计,你看你图里面的这些,很低级。 排版和密度都有问题


从局部的页面映射到全局,进行组件化,组件也可以出UI图
数据库
openai官方文档设计原则,数据库设计应该简单明了,在开发过程中对agent起到规范作用

我们要做的是正式数据库设计,不要一堆规范,这会造成更多幻觉和浪费


/goal 按照现有功能模块,在doc文件夹内建立sql文件夹 按照结构设计完整数据库sql文件
goal任务的定位
Goal 真正需要保留的只有:

1. 依据最新已确认文档。

2. 从账本当前阶段接续,顺序推进,不提前实现后续里程碑。

3. 本次明确授权实施及本地提交,不授权推送、集成、部署和生产操作。

4. 保留已确认的外部验收延期及其推进条件,不扩大例外。

5. 阶段完成后自动继续;缺少必要决定或授权且无可继续工作时停止并报告。

6. 正式完成里程碑播放四次提示音;全部强制验收闭环后才完成整体 Goal。

   Goal 应引用规则,不复制规则;只补充这次任务特有的要求。
执行层面
把所有要开发的建立一个进度账本,沟通分好进度


现在这样顺序开发把 我觉得,多模块用于在一个模块内并发,一下子跨太大怕乱了,我们重新沟通goal


关于调查第三方文档,写入《平台账号与视频发布》的对应技术设计,不只留在临时报告。 这个是需要我们进行沟通的


**新开进程,别用旧进程**


我感觉这个不对,你帮我看看正在执行项目下的那个那个,他为什么这样做 (新进程程找不对的地方)

关于日志的问题:代码要可追溯
修改全局agents话术
我希望AI有相对的可以灵活判断,但不丢失目的

修改全局agents不能写太死,目的是为了让AI可以灵活根据情况判断
AI的本质
- 大模型设计上都是顺从用户的,但不会顺从同行
- 当看不明白的时候,使用下面的技巧(我无法确认到底发生了什么。)为什么这样做?
ai不会去迎合ai, ai对ai 和ai对user是完全不同的,ai训练的底层问题(客观纠错判断)
遇到自己不懂的,疑惑的,使用AI对AI的方式
复制线程id给一个新的线程,你去看看她1h内最近的工作,对比我们的全局agents。md你认为他遵守了吗?
新的线程会客观判断他因为什么用了,因为什么没用

右键-复制-复制深度链接
关于gpt的设置
将防止休眠打开
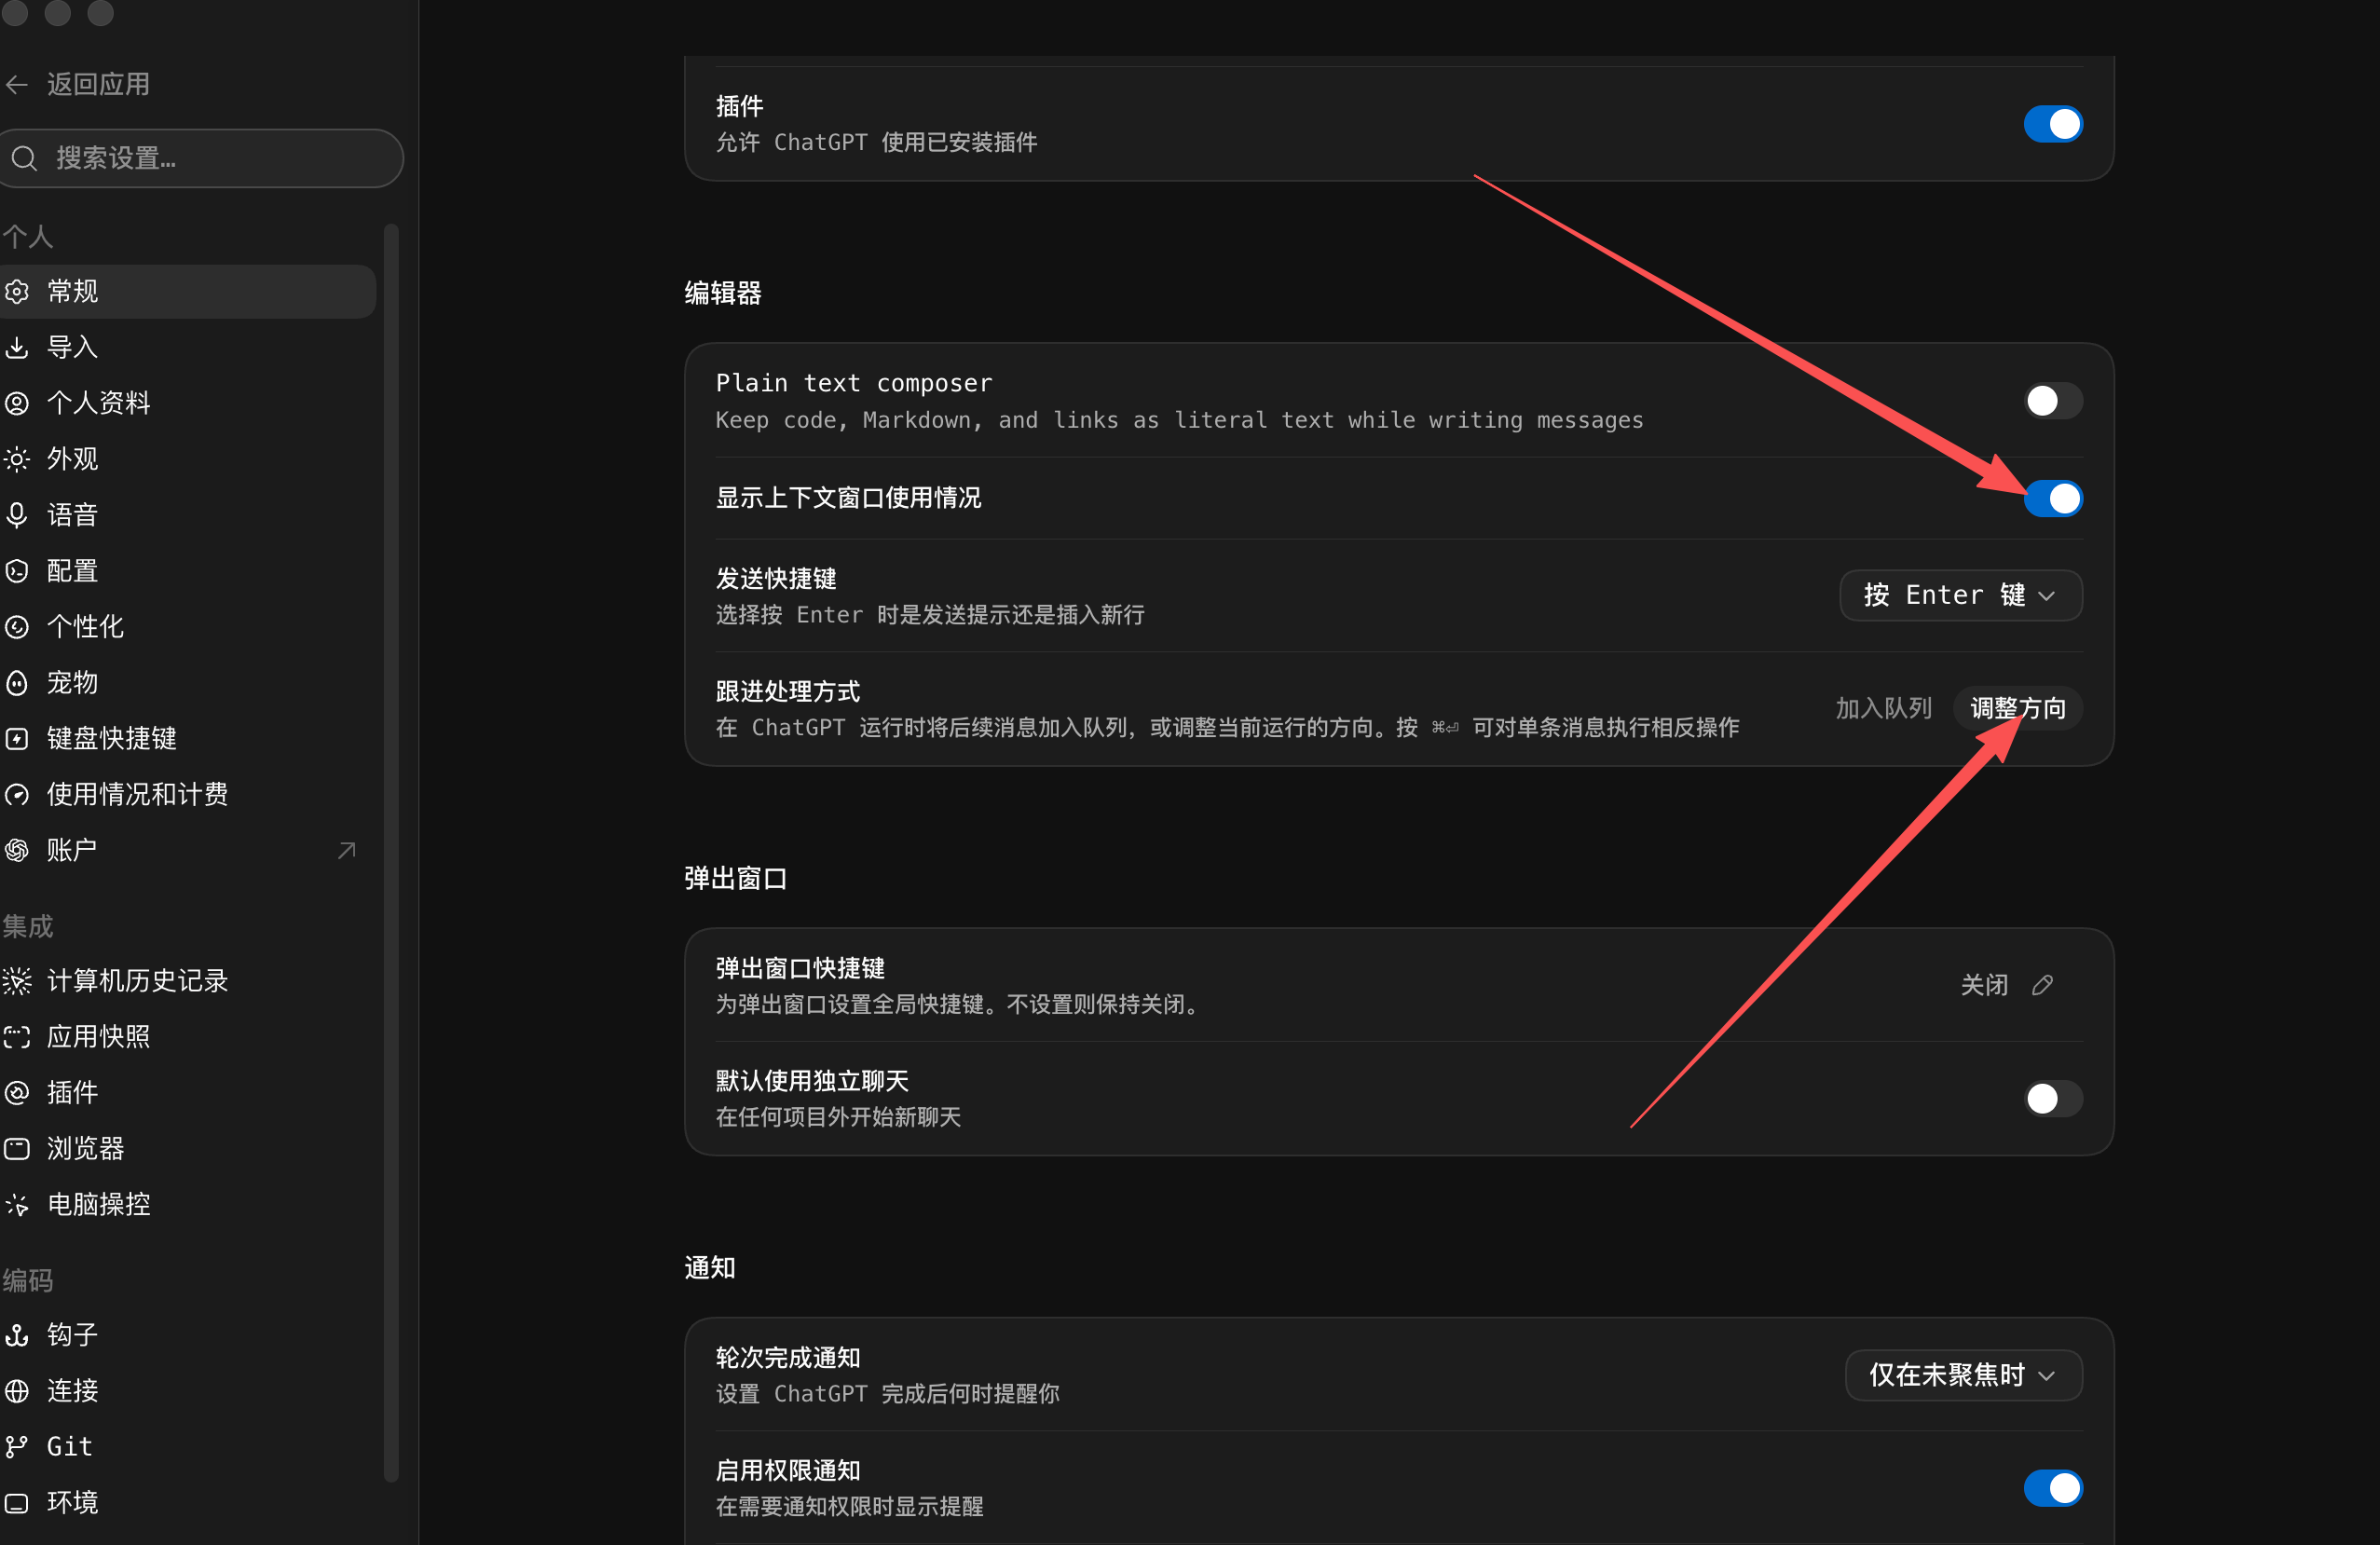
设置根据处理方式
agents/*.toml
- 这里需要区分三个不同层次:
用户 Prompt / Goal:定义“这一次要做什么”。
AGENTS.md:定义“Agent 在开发过程中应该怎样做,以及什么时候应该进行分工”。
agents/*.toml:定义“当某一种子 Agent 被创建以后,它具体使用什么模型、什么推理档位、什么运行配置以及承担什么职责”。- 可以把三者简单理解成:
Prompt / Goal
→ 这次要做什么

AGENTS.md
→ 应该怎么做、什么时候需要子 Agent

agents/*.toml
→ 这个子 Agent 用什么模型、什么权限、负责什么
当 AGENTS.md 判断“源码搜索适合交给 luna_explorer”时,Codex 创建这个子 Agent,并读取对应的 agents/luna_explorer.toml
放置位置:/Users/你的用户名/.codex/agents/luna-explorer.toml
name = "luna_explorer"
description = "Fast read-only agent for focused searches, evidence gathering, and mechanical review."
model = "gpt-5.6-luna"
model_reasoning_effort = "max"
service_tier = "fast"
sandbox_mode = "read-only"
developer_instructions = """
Perform only the delegated read-only investigation.
Use targeted searches, return concise evidence, and leave final issue classification and risk decisions to the parent agent.
Do not modify files, create worktrees, commit, push, deploy, or expose credentials.
"""

[features]
fast_mode = true
AGENTS.md 管“什么时候用谁”,agents/*.toml 管“这个角色是谁、怎么运行”。